25 de agosto de 2026
Optimizar contenido para IA se volvió una de las frases más repetidas del marketing digital en 2026, y también una de las más mal entendidas. La mayoría de las guías mezclan tácticas sin evidencia (agregar un archivo llms.txt, saturar de FAQPage schema) con principios que sí están respaldados por datos reales. Esta guía separa una cosa de la otra, con los estudios que las sustentan.
Qué significa realmente “optimizar para IA”
Cuando alguien le pregunta algo a ChatGPT, Perplexity o ve un AI Overview de Google, el sistema no “navega” tu sitio como lo haría una persona — recupera fragmentos de contenido ya indexado, los evalúa por relevancia y autoridad, y decide cuáles citar en su respuesta. Ese proceso de recuperación depende de que tu contenido responda con precisión, tenga estructura clara, y —sobre todo— que exista evidencia de tu marca más allá de tu propio sitio.
Esto último es el hallazgo más importante y menos intuitivo de toda la investigación reciente: la mayoría de las citas de IA no salen de tu página web. Un análisis de Ahrefs sobre miles de citas de IA encontró que el 84% de las citas provienen de menciones en medios externos (“earned media”), mientras que el sitio propio de la marca representa apenas entre el 5% y el 10% de lo que los motores de IA terminan referenciando — la misma dinámica que ya se ve en cómo las búsquedas sin clics están cambiando qué cuenta como éxito para el contenido de una marca: ser mencionado y citado importa aunque no siempre se traduzca en una visita directa.
Qué correlaciona con ser citado (con datos reales)
La pregunta que casi todos hacen es cuál es “la táctica” para aparecer en respuestas de IA. La respuesta honesta es que no hay una sola táctica — hay factores con distinto peso, y algunos de los más promocionados en la industria tienen una correlación sorprendentemente baja.
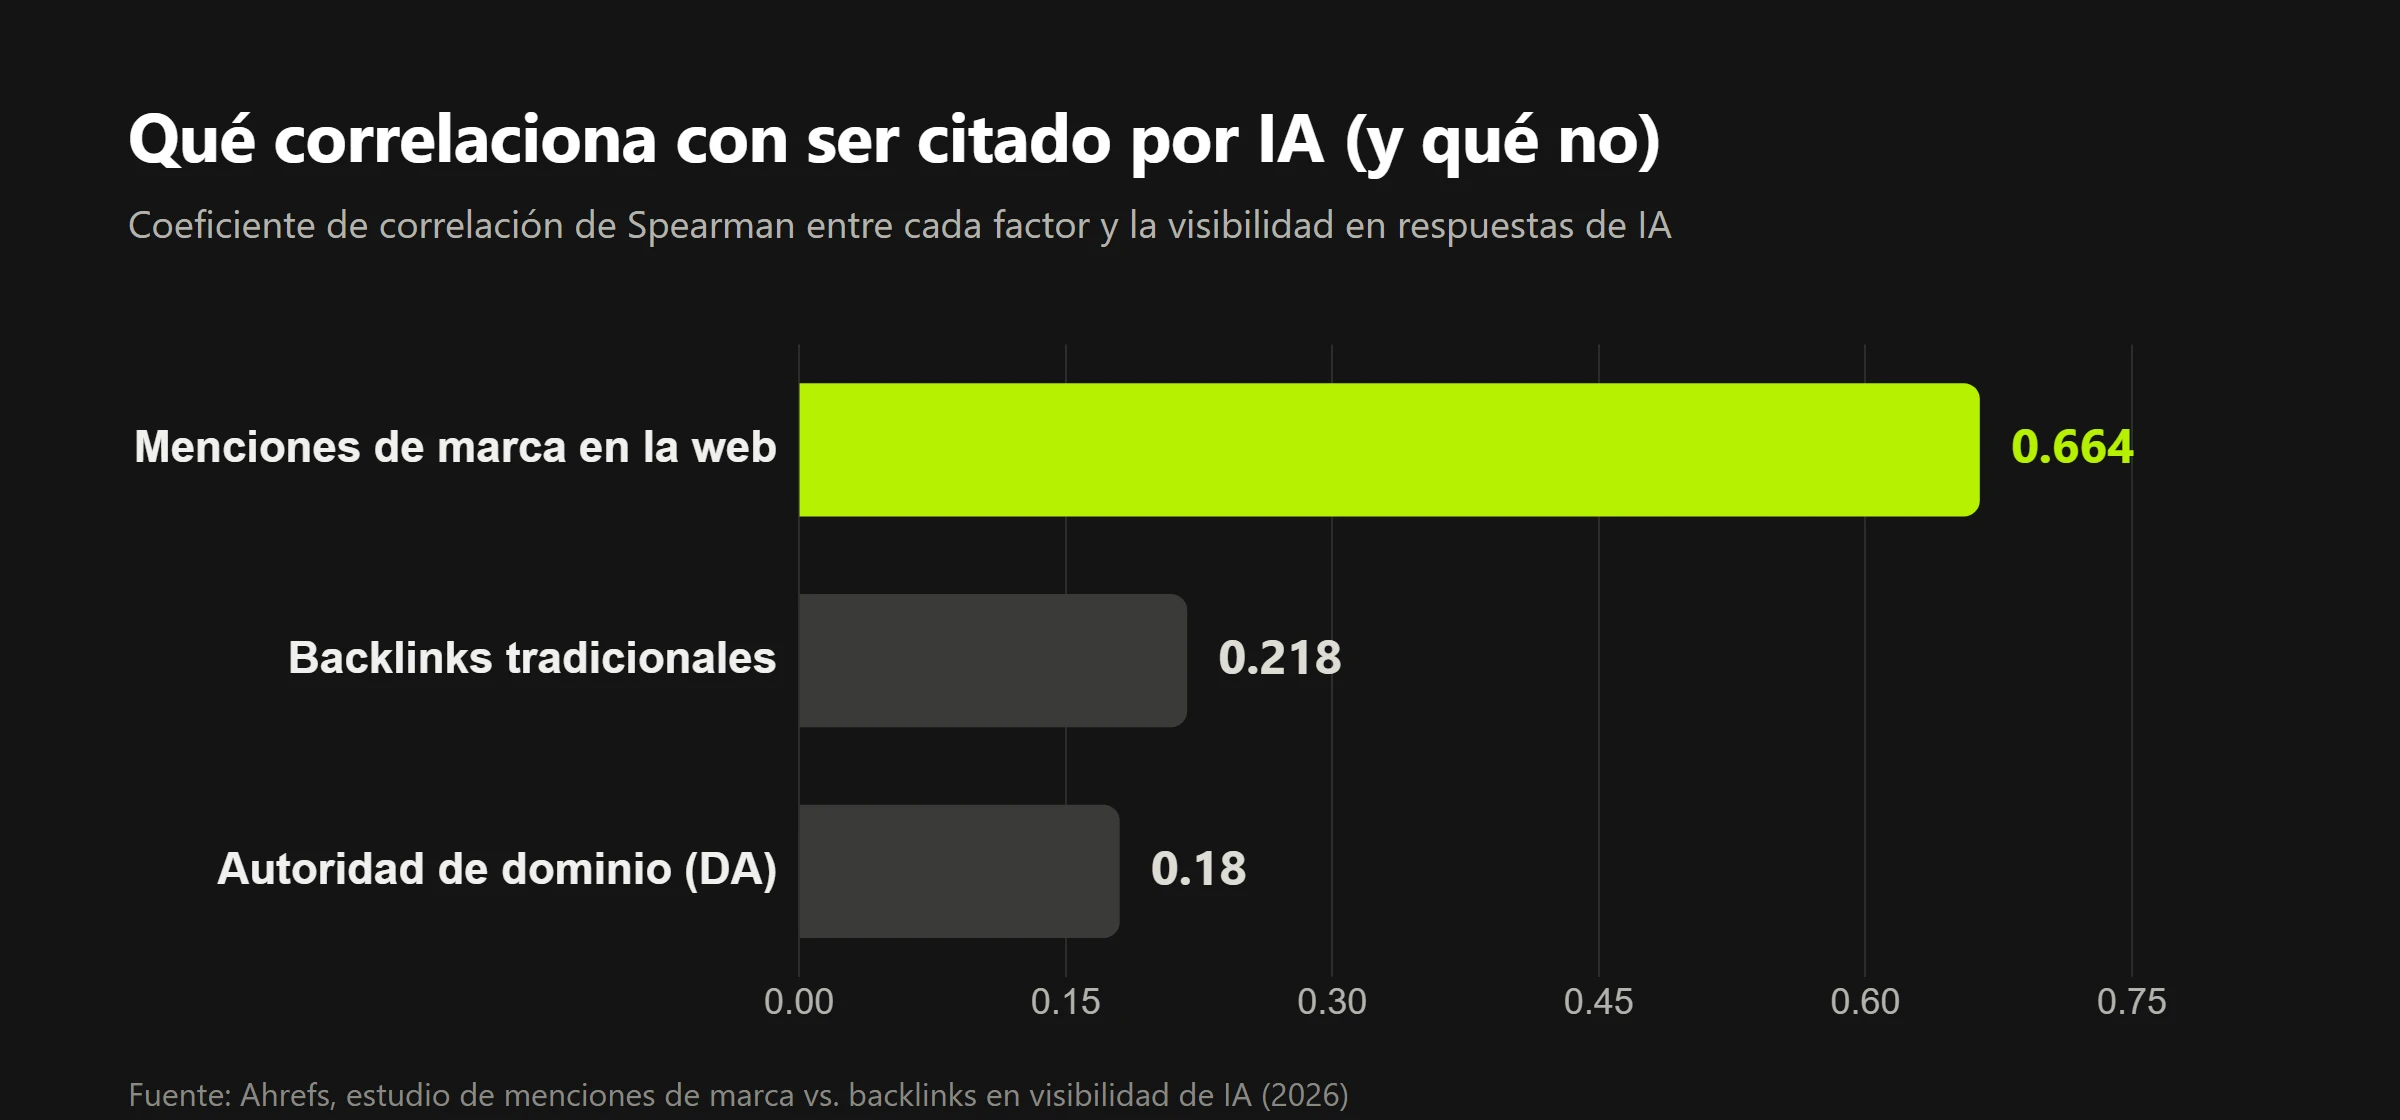
Menciones de marca en la web correlacionan casi 3 veces más que los backlinks tradicionales con aparecer citado por IA.
Los datos del mismo estudio de Ahrefs son claros: las menciones de marca en la web tienen una correlación de 0.664 con la visibilidad en IA, frente a apenas 0.218 de los backlinks tradicionales y 0.18 de la autoridad de dominio — dos métricas en las que la industria SEO invirtió años de esfuerzo y que siguen importando para el buscador tradicional, pero pesan mucho menos en cómo te cita un motor de IA.
A nivel de contenido puntual, la misma investigación encontró que agregar citas textuales de fuentes aumenta la visibilidad 41%, incluir estadísticas la sube 33%, y citar fuentes externas la sube 28%. El patrón se repite en otros análisis: contenido con formato de preguntas y respuestas directas tiene 40% más probabilidad de ser citado, y el contenido con estadísticas concretas obtiene entre 30% y 40% más visibilidad que el contenido sin datos.
La cifra que resume todo esto: una afirmación como “las campañas de marketing con IA generan entre 20% y 30% más ROI” tiene mucha más probabilidad de ser citada que “el marketing con IA mejora los resultados” — el dato específico y verificable gana sobre la afirmación vaga, sin excepción.
Cómo estructurar el HTML para que la IA “entienda” el contenido
Antes de que un motor de IA decida qué citar, tiene que dividir tu página en fragmentos (“chunks”) que pueda procesar por separado. Según una explicación técnica de cómo los agentes de IA leen contenido, este proceso de chunking estructural usa los encabezados, párrafos y etiquetas HTML como límites naturales — un fragmento con jerarquía de encabezados clara sobrevive como una unidad coherente; uno sin esa estructura se corta en cualquier parte, incluso a mitad de una idea.
Esto vuelve crítico algo que el SEO tradicional ya recomendaba pero que ahora tiene una razón técnica más directa: la jerarquía de encabezados debe ser secuencial, sin saltos.
<!-- Correcto: jerarquía secuencial, cada H2 con su propio tema -->
<h1>Cómo optimizar contenido para IA</h1>
  <h2>Qué factores correlacionan con ser citado</h2>
  <h2>Cómo estructurar el HTML</h2>
    <h3>Jerarquía de encabezados</h3>
    <h3>Datos estructurados en el texto</h3>

<!-- Incorrecto: salta de H1 a H3, usa negrita en vez de encabezado -->
<h1>Cómo optimizar contenido para IA</h1>
  <h3>Qué factores correlacionan</h3>
  <p><strong>Cómo estructurar el HTML</strong></p>
Un análisis de Siteimprove sobre extracción de contenido por IA confirma el motivo: saltarse niveles de encabezado o reemplazar un encabezado real por texto en negrita causa lo que llaman “colisiones de recuperación” — el sistema de IA no logra determinar dónde empieza y termina un tema, y el fragmento pierde contexto o se cita fuera de lugar.
El caso llms.txt: por qué no funciona (con datos)
Cuando empezó a hablarse de GEO, una de las primeras recomendaciones que circuló fue crear un archivo llms.txt — una especie de “sitemap para IA” en la raíz del dominio. La idea sonaba razonable, pero un estudio de Ahrefs sobre 137,210 dominios le puso números encima, y no fueron buenos: el 97% de los archivos llms.txt no recibieron ni una sola solicitud de un bot de IA en mayo de 2026.
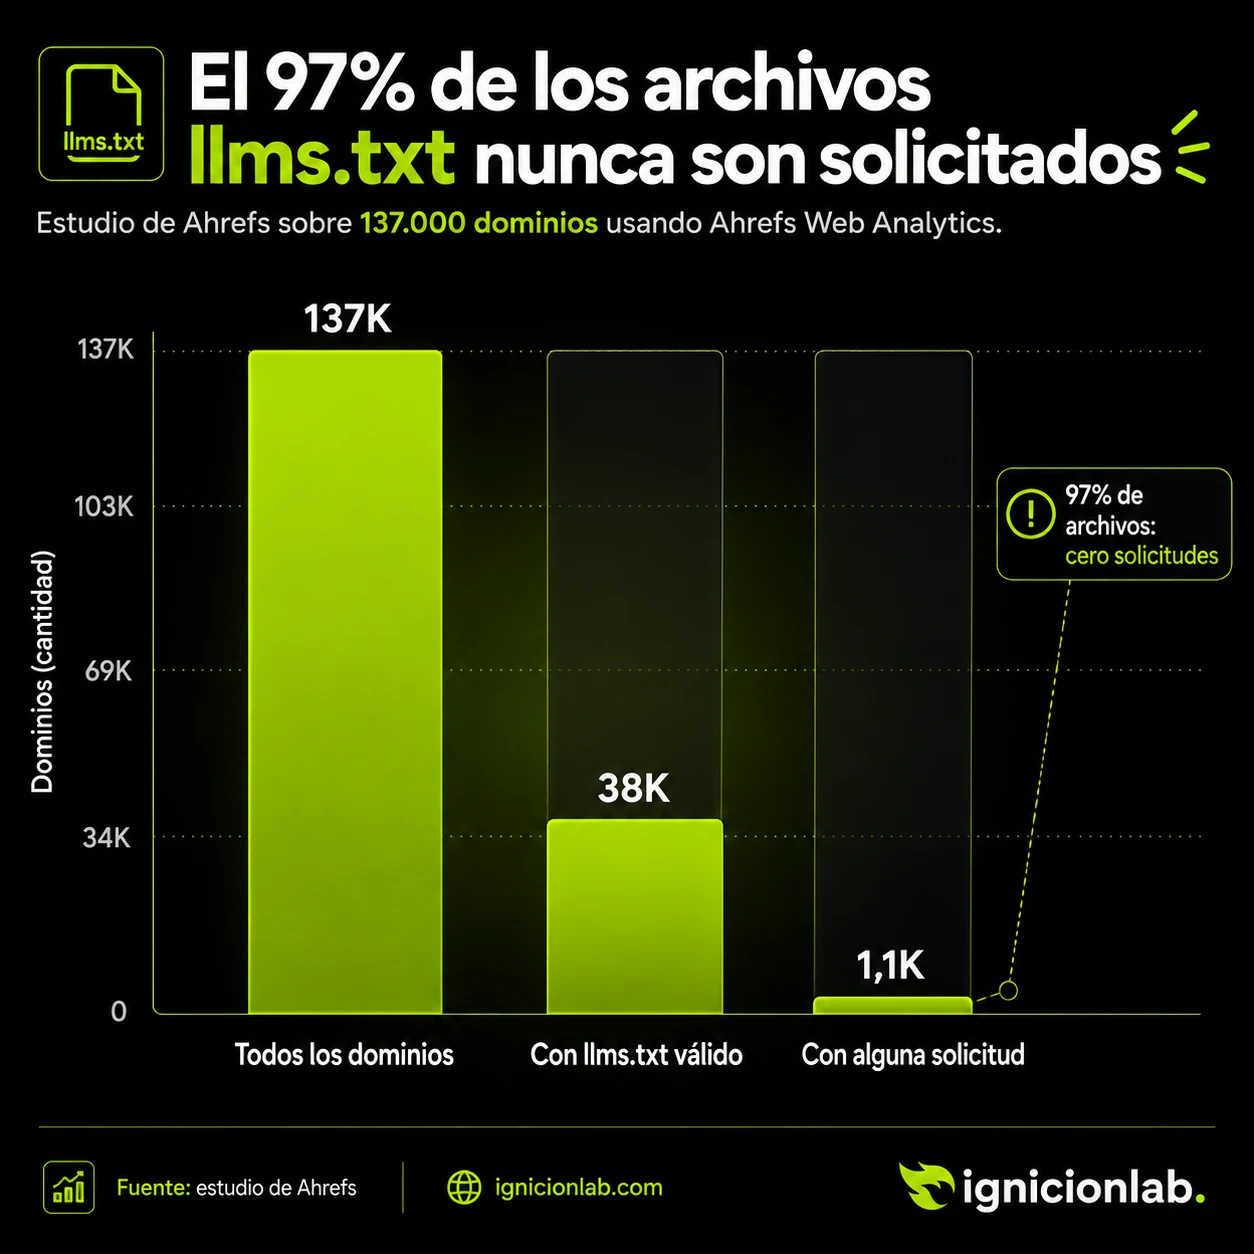
De 38,000 dominios con llms.txt válido, solo 1,100 (el 3%) recibieron al menos una solicitud.
El detalle que más llama la atención es quién sí los lee: entre el pequeño porcentaje de tráfico que reciben estos archivos, las herramientas de auditoría SEO representan el 21.7% de las solicitudes, más que cualquier bot real de IA — es decir, la mayoría del tráfico a un llms.txt viene de otras herramientas de marketing verificando si existe, no de ChatGPT o Perplexity buscando información. Google ya había confirmado antes que este archivo no afecta ni a Search ni a AI Overviews.
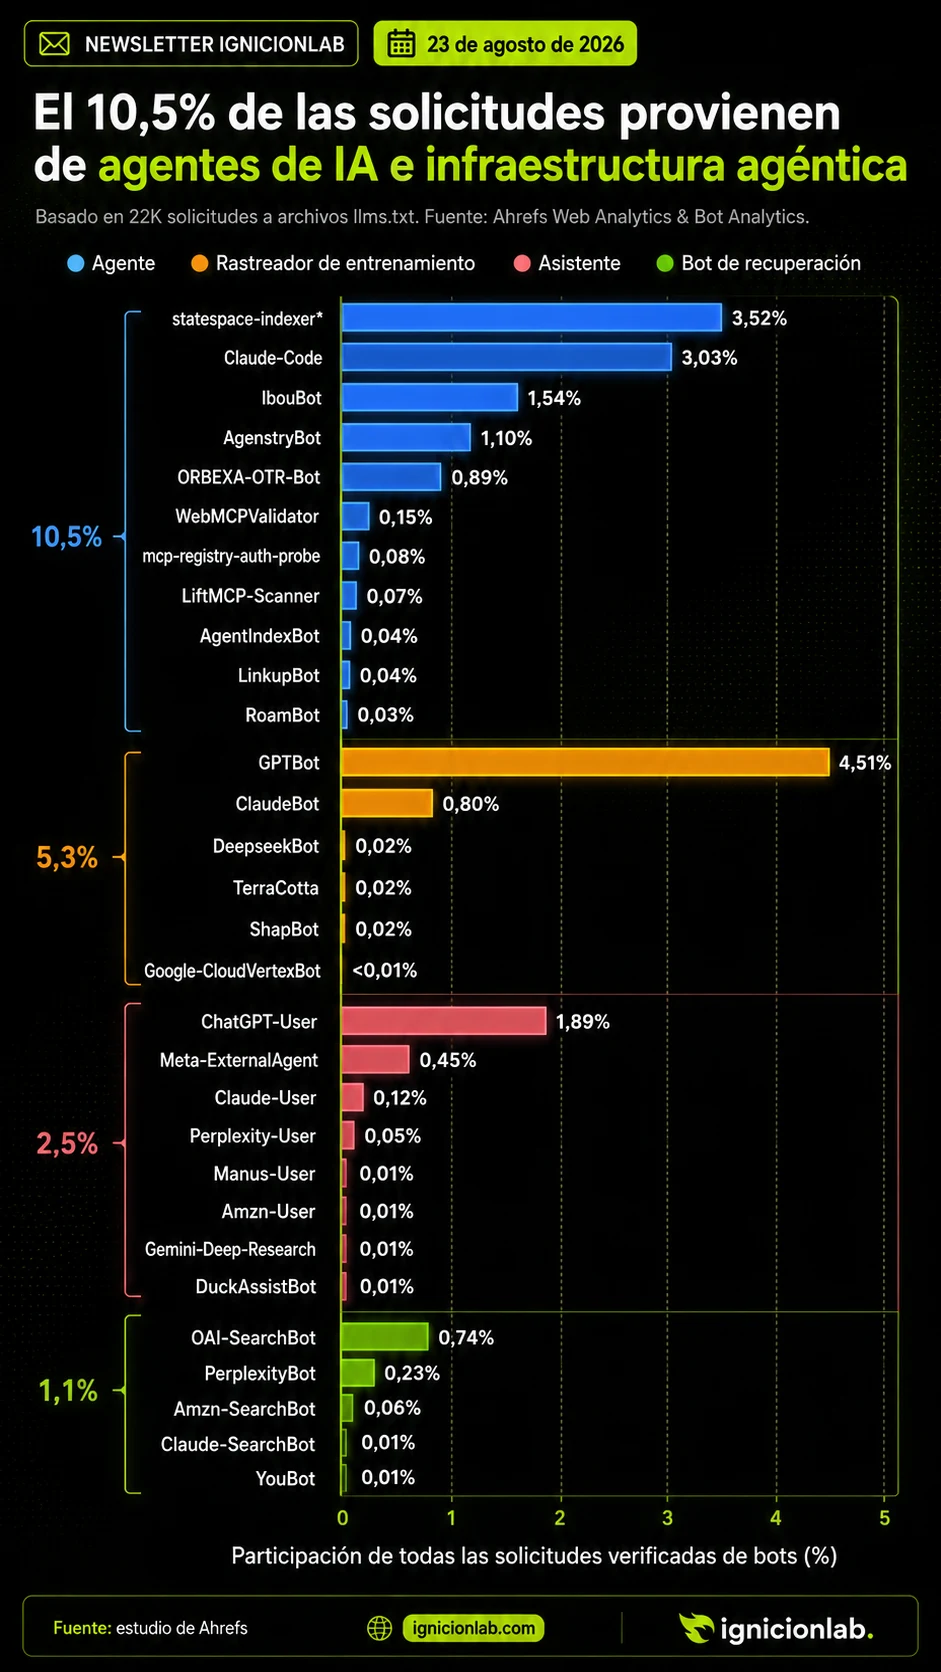
Ni el bot más activo (GPTBot, rastreador de entrenamiento) llega al 5% de las solicitudes — y ningún bot de recuperación en tiempo real (los que sí influyen en una respuesta de ChatGPT o Perplexity) supera el 1%.
Esto no es un caso aislado. La misma lógica de “suena razonable pero no hay evidencia” aplica al schema markup como estrategia de citación: Ahrefs rastreó 1,885 páginas que agregaron JSON-LD entre agosto de 2025 y marzo de 2026, comparadas contra 4,000 páginas de control, y no encontró un cambio estadísticamente significativo en citas de IA — porque los modelos de lenguaje leen principalmente el HTML visible, no el markup estructurado que solo procesan los buscadores tradicionales.
Qué hacer con esta información
No hace falta ejecutar una lista larga de tácticas — con los datos anteriores, el orden de prioridad queda bastante claro:
- Prioriza que te mencionen fuera de tu sitio antes que perseguir backlinks o domain authority — es el factor con más del triple de correlación real.
- Escribe con datos específicos y cita tus fuentes, no afirmaciones genéricas — es la diferencia entre 41% más visibilidad y quedar fuera de la respuesta.
- Cuida la jerarquía de encabezados como si fuera la única forma en que un sistema puede entender de qué habla cada sección — porque, en la práctica, lo es.
- No inviertas tiempo en
llms.txtni en schema como estrategia de citación — ambos tienen evidencia real de que no mueven la aguja.
El 88% de las citas de ChatGPT llegan a través del canal de búsqueda general — no existe un atajo GEO que funcione independientemente del SEO tradicional. Si tu contenido no rankea bien en Google, tampoco tiene muchas probabilidades de aparecer citado en una respuesta de IA, sin importar cuántas de las tácticas de esta lista apliques.