18 de agosto de 2026
Hace poco agregamos una herramienta de auditoría gratuita a nuestro propio sitio — el tipo de widget donde alguien pega su URL y recibe un mini-reporte al instante. Antes de escribir una sola línea, nos hicimos una pregunta que la mayoría de los equipos se salta: ¿esta herramienta va a generar una URL nueva cada vez que alguien la use? Si la respuesta es sí, hay que pensarlo dos veces.
El problema que casi nadie ve venir
El patrón más común para construir algo así es simple: el usuario llena un formulario, el sitio redirige a una página de resultado, esa página lleva el input como parámetro en la URL — algo como /resultado?url=sitio-del-usuario.com. Funciona, se ve bien, y es exactamente el tipo de arquitectura que Google Search Central lleva más de una década advirtiendo que genera problemas, desde su publicación original sobre contenido duplicado causado por parámetros de URL.
Cada combinación distinta de parámetro es, para un motor de búsqueda, una URL distinta. Si mil personas usan tu herramienta con mil sitios diferentes, generaste mil páginas nuevas — casi todas con el mismo layout, el mismo texto de relleno alrededor del resultado, y una sola línea de dato real que cambia. Eso tiene un nombre en SEO técnico: thin content, contenido delgado que no aporta suficiente valor único para justificar que un buscador lo indexe.
Por qué el contenido delgado te cuesta más de lo que parece
El daño no es solo estético. Cuando un rastreador dedica tiempo a recorrer cientos de páginas casi idénticas generadas por parámetros, está gastando presupuesto de rastreo (crawl budget) en contenido que no aporta nada, en vez de dedicarlo a las páginas que sí quieres que se indexen rápido. Google también puede terminar dividiendo la autoridad de enlace entre múltiples versiones de lo que en realidad es la misma página, en vez de consolidarla en una sola URL fuerte.
Hay un matiz importante: no es solo un problema de “muchas páginas”. Es un problema de páginas que existen sin haber sido invitadas a existir. Un blog con 200 artículos bien escritos no tiene este problema —cada uno responde una intención de búsqueda distinta—, pero 200 páginas de resultado con la misma estructura y solo un dato que cambia sí lo tiene, aunque el número sea el mismo.
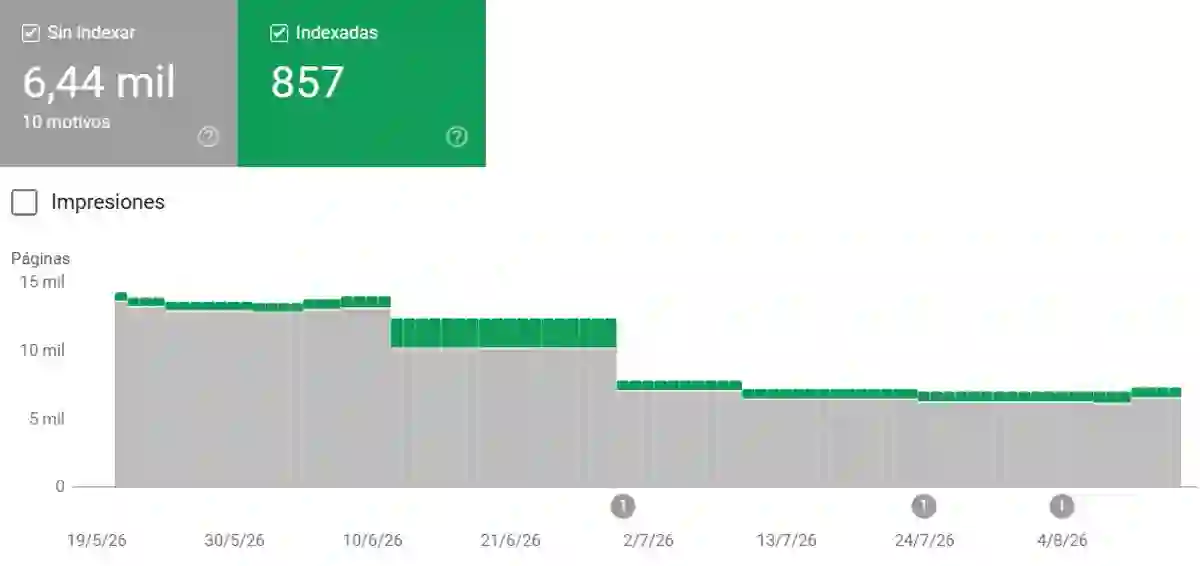
Así se ve el síntoma en Google Search Console cuando un sitio genera de más: miles de páginas que Google decidió no indexar, frente a un puñado que sí considera con valor real.
La alternativa que elegimos: nunca crear la URL
En vez de generar una página de resultado, diseñamos la herramienta para que el reporte aparezca directamente sobre la misma página donde ya estaba el formulario — sin redirección, sin parámetro nuevo, sin ruta adicional. Quien la usa ve su resultado al instante, en el mismo lugar donde hizo clic, y la URL de esa página no cambia en ningún momento del proceso.
El resultado técnico es que la herramienta puede usarse un millón de veces sin generar una sola página nueva que rastrear. No hay nada que indexar por accidente, no hay contenido duplicado que limpiar después, y no hay que decidir entre bloquear esas rutas con robots.txt o dejarlas sueltas — porque simplemente no existen como páginas independientes.
Cómo lo resolvimos en nuestra propia auditoría SEO
Al desarrollar nuestra herramienta gratuita de auditoría SEO nos encontramos con un problema: si cada análisis generaba su propia dirección, acabaríamos creando URLs del tipo ignicionlab.com/auditoria-seo/?url=ejemplo.com o incluso una página diferente para cada dominio analizado.
Teniendo en cuenta que un usuario puede auditar su web, la de varios competidores o las de distintos clientes, eso podía traducirse rápidamente en cientos o miles de URLs sin valor real para Google.
¿Cómo lo resolvimos? Manteniendo una única URL para todas las auditorías: ignicionlab.com/auditoria-seo/.
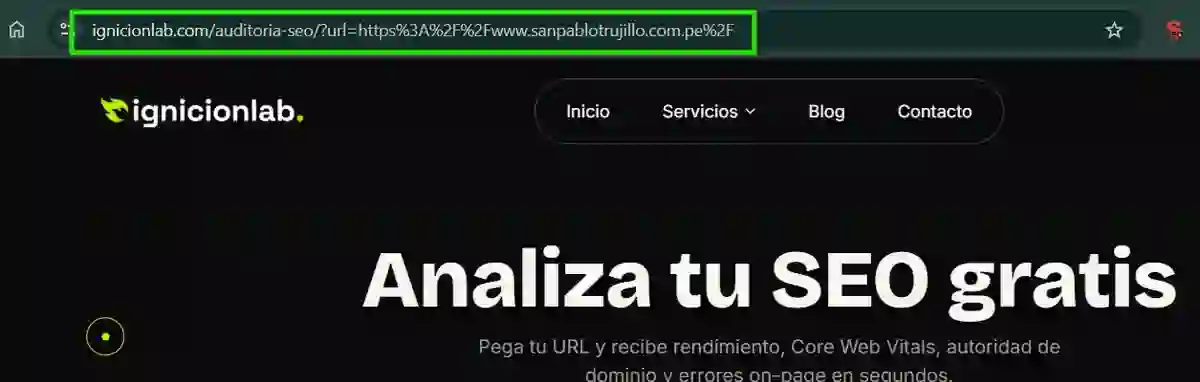
El parámetro ?url= que se ve ahí solo sirve para precargar el formulario con la web que se quiere analizar — la ruta base nunca cambia, así que para un rastreador sigue siendo la misma página de siempre.
Cuando el usuario envía el formulario, el análisis se ejecuta y JavaScript muestra los resultados directamente sobre esa misma página, desde el navegador. Técnicamente, lo que pasa es una actualización del DOM —el árbol de elementos que ya está cargado en esa pestaña— y no una navegación nueva: no hay un segundo document que el navegador solicite al servidor, así que no hay una URL nueva que Google pueda encontrar al rastrear, ni un <title> o <meta> distintos que indexar como si fuera otra página. No necesitamos crear una página nueva para cada dominio analizado ni una URL diferente que Google pueda descubrir e intentar indexar.
La diferencia se ve clara comparando los dos enfoques en código. Esto es lo que no conviene hacer, porque cada envío termina en una URL distinta:
// Genera una URL nueva por cada envío — la evitamos
form.addEventListener('submit', (e) => {
  e.preventDefault();
  const url = new FormData(form).get('url');
  window.location.href = `/resultado?url=${encodeURIComponent(url)}`;
});
Y esto es, en esencia, lo que sí hacemos: la URL de la pestaña no cambia en ningún momento.
// Actualiza el DOM en la misma página — la URL nunca cambia
form.addEventListener('submit', async (e) => {
  e.preventDefault();
  const url = new FormData(form).get('url');
  const data = await fetch(`/api/analizar?url=${encodeURIComponent(url)}`).then(r => r.json());
  resultadoContainer.innerHTML = renderResultado(data);
});
Lo mismo ocurre con los widgets de auditoría que tenemos repartidos por otras secciones de la web. Su función es llevar al usuario hasta esa herramienta con la web que quiere analizar ya preparada, pero el resultado siempre termina mostrándose en el mismo lugar.
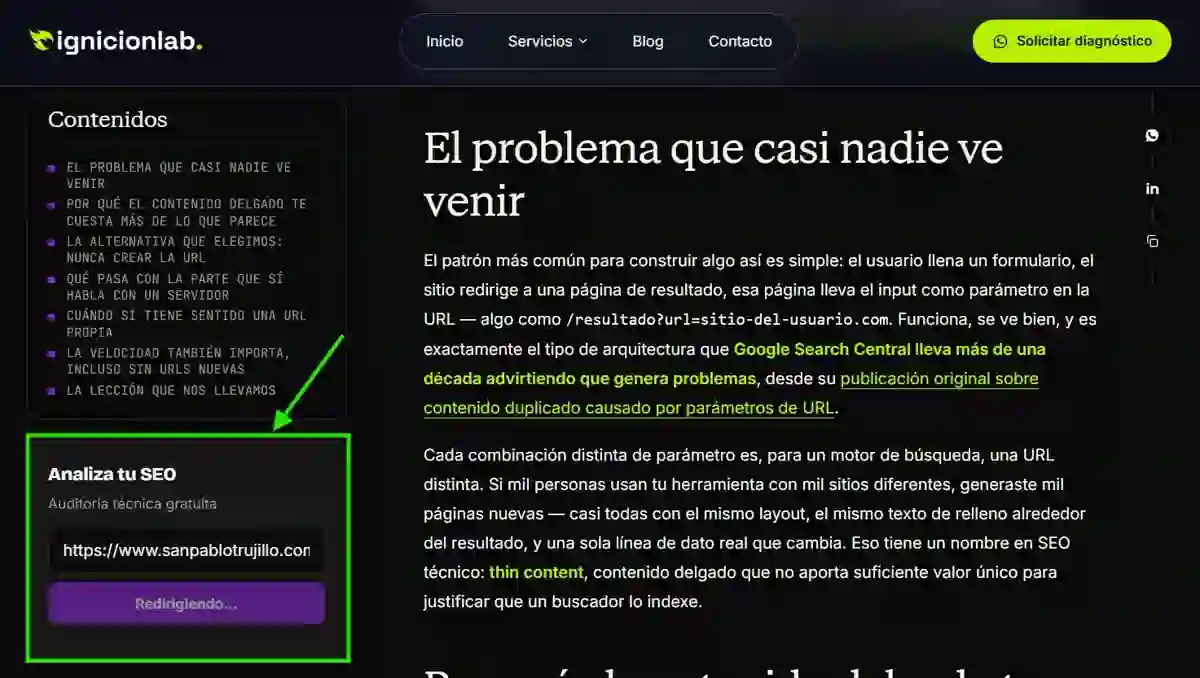
El widget que ves en este mismo artículo, en el sidebar, es uno de esos casos: no calcula nada ahí — solo redirige a la página única de la herramienta con la URL ya cargada.
Así conseguimos algo muy sencillo: una única página real para la herramienta, independientemente de que se realicen diez, mil o cien mil auditorías, evitando generar URLs innecesarias que los buscadores tengan que rastrear, evaluar y descartar, y sin afectar negativamente al SEO del sitio.
URLs dinámicas y SEO: por qué se generan URLs innecesarias y cómo evitarlas
| Causa común | Suele verse en | Por qué genera URLs de sobra | Cómo evitarlo |
|---|---|---|---|
Parámetros de tracking (?utm_source=, ?ref=, ?fbclid=) |
Cualquier sitio con campañas pagadas | Cada combinación de campaña crea una URL técnicamente distinta para el mismo contenido | rel="canonical" apuntando a la URL limpia |
Filtros y ordenamiento en catálogos (?color=azul&orden=precio) |
E-commerce | Cada combinación de filtros arma una URL nueva, casi siempre con el mismo contenido base | Canonical hacia la versión sin filtrar; noindex en combinaciones de bajo valor de búsqueda |
Parámetros de sesión o de usuario (?sessionid=, ?ref_user=) |
Sitios con login o programas de afiliados | Identifican a la persona, no el contenido — generan una URL única por visita | Nunca deberían depender de query params; si es inevitable, noindex, follow |
Paginación interna (?page=2, ?page=3) |
Blogs, foros, catálogos grandes | Contenido parcialmente duplicado entre páginas, difícil de indexar como unidad | rel="next"/"prev" donde aplique, o consolidar en una sola página si el contenido lo permite |
Herramientas interactivas que devuelven resultado por URL (/resultado?url=...) |
Calculadoras, cotizadores, auditorías | Una URL nueva por cada input de cada usuario — el caso que motivó este artículo | Pintar el resultado sobre el DOM de una URL fija, como hicimos en nuestra auditoría SEO |
Facetas de búsqueda interna (?q=zapatos+azules) |
E-commerce | Resultados de búsqueda interna indexados como si fueran contenido editorial | noindex en rutas de búsqueda interna; bloquear en robots.txt si el volumen es alto |
Qué pasa con la parte que sí habla con un servidor
Esto no significa que la herramienta no se comunique con nada — sí necesita pedir datos a un servidor para calcular el resultado. La diferencia está en qué responde esa comunicación: no una página HTML completa pensada para navegadores y buscadores, sino un paquete de datos puro, pensado únicamente para que el código de la página lo lea y lo muestre. Un motor de búsqueda no tiene ningún motivo para tratar eso como contenido — no es una página, es una respuesta a una pregunta puntual, tan efímera como el clic que la generó.
En código, esa petición se ve así — nótese que la respuesta es datos puros, no HTML:
const respuesta = await fetch('/api/analizar?url=sitio-ejemplo.com');
const datos = await respuesta.json();
// datos = { puntuacion: 82, problemas: ["falta meta description"], ... }
Ese JSON no tiene <title>, ni <meta>, ni una URL propia que un rastreador pueda descubrir — es información cruda que el JavaScript de la página ya cargada usa para actualizar lo que el usuario ve.
Cuándo sí tiene sentido una URL propia
Esto no es una regla absoluta contra las páginas dinámicas. Si el resultado de una herramienta es algo que la gente quiere compartir o volver a visitar —un reporte que alguien envía por WhatsApp, una comparación que quiere guardar en favoritos—, entonces sí conviene que tenga su propia URL, idealmente con una estructura limpia y un rel="canonical" bien definido para evitar duplicados, como recomienda la propia documentación de Google. La pregunta correcta no es “¿debería tener URL o no?” en abstracto, sino “¿esta URL le sirve a alguien más además de la persona que la generó?”. Si la respuesta es no, no la crees.
La velocidad también importa, incluso sin URLs nuevas
Evitar páginas duplicadas resuelve un problema, pero no todos. Una herramienta interactiva que tarda en responder o que hace que el resto de la página salte mientras carga sigue penalizando la experiencia — y eso Google también lo mide, con métricas que ya dejamos de ignorar en nuestra propia auditoría de Core Web Vitals. Diseñar bien el “dónde vive el resultado” es solo la mitad del trabajo; la otra mitad es que aparezca rápido y sin fricción.
La lección que nos llevamos
Cada elemento interactivo que agregas a un sitio es, en el fondo, una decisión de arquitectura antes que una decisión de diseño. Es fácil enfocarse en cómo se ve el formulario y el botón, y mucho más fácil olvidar preguntar qué pasa técnicamente el segundo después de que alguien hace clic. Nosotros preferimos que la respuesta fuera “nada nuevo que rastrear” — la misma filosofía de fondo que aplicamos cuando pensamos en contenido que aporta valor sin depender solo del volumen de tráfico que genera, la misma idea detrás de repensar qué significa el éxito ahora que la mayoría de las búsquedas terminan sin un clic.